新开源论文:知识蒸馏与迁移学习驱动的建筑群地震峰值响应预测方法
论文:A knowledge distillation-based transfer learning framework for peakseismic response prediction of urban building clusters.
DOI:https://doi.org/10.1016/j.engstruct.2026.123348
代码和数据:https://github.com/qinglecheng/kd-tl-seismic-response-prediction
0
太长不看版
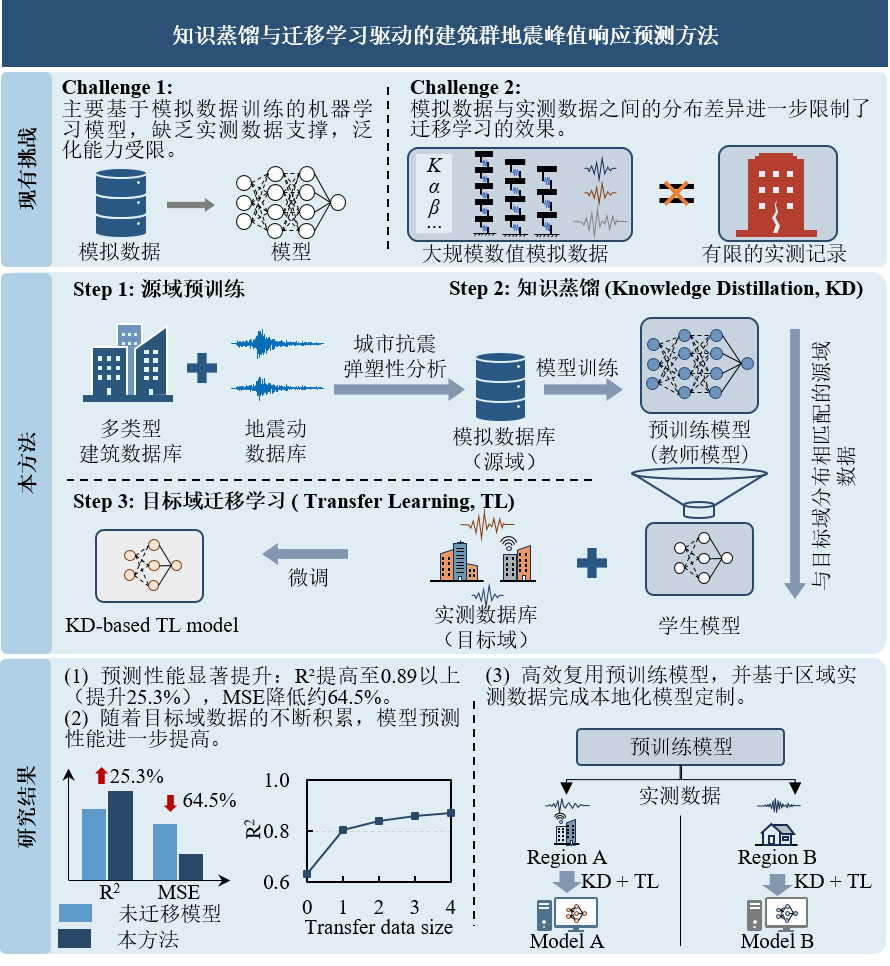
地震后,如何快速预测城市中大量建筑的地震响应,是震害评估和应急决策的重要问题。近年来基于机器学习算法的城市震损评估方法得到大量研究。但是由于真实结构地震响应数据很少,难以满足AI训练要求;而通过数值模拟构造的仿真数据又与真实建筑响应存在较大差别,往往无法满足震损分析需要,从而成为当前研究的一个关键难题。
为此,本文提出了一种知识蒸馏–迁移学习框架:先让复杂的教师模型(百万参数)从海量仿真数据中学习建筑地震响应的通用规律,再将这些知识“蒸馏”给轻量化学生模型(6721个参数),并结合少量实测数据进行迁移微调。验证结果表明,该方法在实测数据有限的情况下仍能取得较好效果,R2达到0.89,相比未迁移模型提升约25.3%,MSE降低约64.5%。
总体而言,该方法能够兼顾仿真数据“量大”和实测数据“真实”的优势,可根据目标区域的实测数据进行本地化定制,并随着监测数据不断积累实现持续更新,为城市建筑群震后快速响应预测提供了一种高效、可靠的技术路径。
常见问题(FAQ)
为什么要做迁移学习?
建筑的强震监测数据是非常稀缺的,数量级往往仅以百计,用这样的数据训练出一个比较复杂的模型基本是不可能的。所以先用大量仿真数据进行预训练,再用少量真实监测数据去迁移微调是较好的解决方案。
为什么要做知识蒸馏?
直接用仿真数据训练一个和学生模型规模相当的小模型然后再做迁移微调技术上是可行的。但是这种方法的重复工作量会大很多。例如:假定目标区域最初只有几个4层的教学楼做了监测,于是使用单位先针对4层建筑做了建模和大量仿真,并用仿真数据训练了小模型,再结合4层教学楼的监测数据进行迁移微调。然而,不久后目标区域又增加监测了一个6层的医院,于是上述的建模、仿真、训练工作又要重复一遍,需要耗时十几个小时。用本文的方法就只要从已有的教师模型中再“蒸馏”一个6层医院的学生模型即可,只需要十几分钟即可,效率可以极大提升。
1
为什么要做这件事?
仿真数据规模大、覆盖范围广,可以说是“量大管饱”,但与结构实测响应数据之间存在一定的差异;而实测数据能够真实反映结构地震响应,可以说是“少而精”,但获取成本高、样本数量有限,难以直接支撑深度学习模型训练。
那么,有没有一种方法,既能享受仿真数据“量大管饱”的优势,又能利用实测数据“少而精”的价值?
有!本文就提出了一种基于知识蒸馏的迁移学习方法,构建融合仿真与实测数据的建筑群地震峰值响应预测框架。
2
框架总览
本文提出的基于知识蒸馏和迁移学习的建筑群地震峰值响应预测方法分为四步(图1):
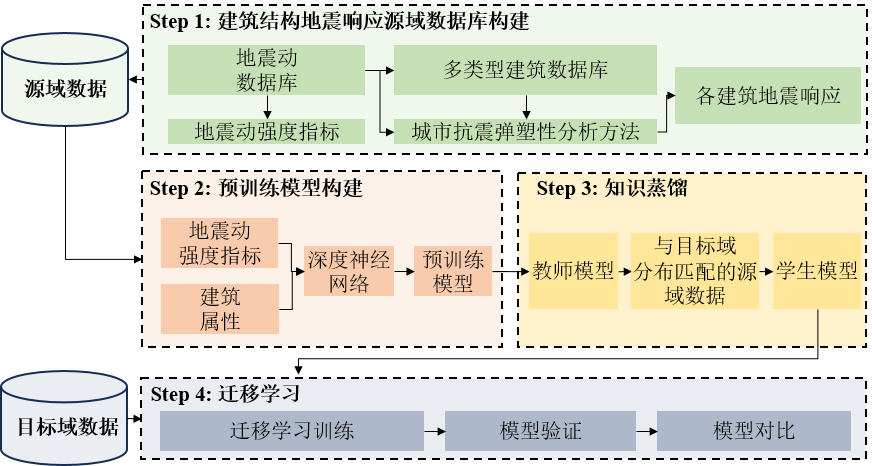
图1 知识蒸馏-迁移学习框架流程图
Step 1:源域数据库构建
首先,基于HAZUS建筑分类体系(美国FEMA提出的建筑地震损失评估方法,包含13种典型建筑结构类型)建立多类型建筑数据库(建筑类型包括不同建筑高度、建造年代、建筑层数与结构类型);结合NGA-West2地震动数据库,提取能够表征地震动特性的地震动强度指标(本研究采用了包括峰值、频谱、时间与能量相关的19种地震动强度指标,具体可参考论文Table B1)。随后,采用城市抗震弹塑性分析方法,计算不同建筑在不同地震动作用下的峰值响应,包括顶层峰值加速度(PTFA)和最大层间位移角(MIDR),最终建立覆盖多种建筑类型的大规模源域地震响应数据库,数据量共计900多万。
Step 2:教师模型预训练
预训练模型架构如图2所示,模型以地震动强度指标、建筑属性作为输入,以建筑峰值地震响应作为预测输出,构建带有注意力机制的深度神经网络。最后,利用源域地震响应数据库对教师模型进行预训练,使模型充分学习地震动特征、建筑属性与结构峰值响应之间复杂的非线性映射关系。(详细介绍可参考:https://www.tandfonline.com/doi/full/10.1080/13632469.2026.2680115)
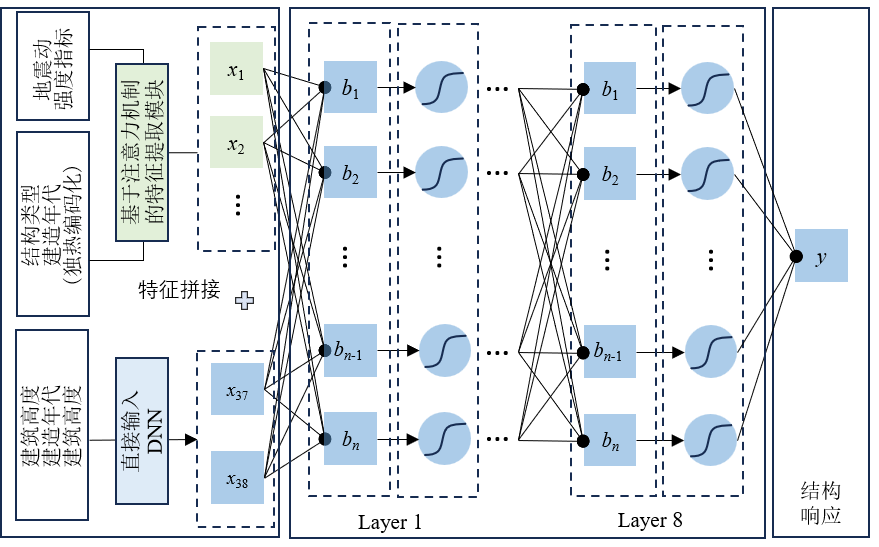
图2 预训练模型架构
Step 3:知识蒸馏
知识蒸馏可以理解为“大模型教小模型”:先让复杂的教师模型从海量仿真数据中学习建筑地震响应的通用规律,再把这些规律以更简洁的形式传递给轻量化的学生模型。这样,学生模型既能继承大模型的预测能力,又更容易结合少量实测数据进行快速适配和更新。
以源域预训练模型为教师模型,通过蒸馏过程提取并压缩模型中蕴含的高层特征知识,结合与目标域分布匹配的源域样本(即根据目标域建筑属性,如层高范围,筛选出的源域数据),在教师模型软标签的监督下进行训练,从而获得参数轻量化、适应性更强的学生模型。该过程实现了从跨类型源域知识向特定目标域知识的高效转移。
Step 4:迁移学习
以知识蒸馏得到的学生模型作为初始化模型,冻结部分网络参数,利用实测地震响应数据进行迁移学习微调,实现模型向目标域的快速适配,并通过模型验证与对比分析评估本方法的有效性。
3
案例验证:效果怎么样
3.1本方法性能如何?
以CESMD(美国工程强震动数据库)实测数据(选择数据集中的1-3层建筑)为基准,分别选取未迁移模型(仅利用源域仿真数据训练)、直接迁移模型(预训练模型直接迁移至目标域微调,不进行蒸馏)以及基准模型(仅利用目标域实测数据训练)进行对比,并采用K折交叉验证评估模型性能。结果表明(图3),本文提出的知识蒸馏迁移学习框架具有更高的预测精度和更好的泛化能力,决定系数达到0.89以上,相比于传统未迁移模型提升25.3%,均方误差降低约64.5%。
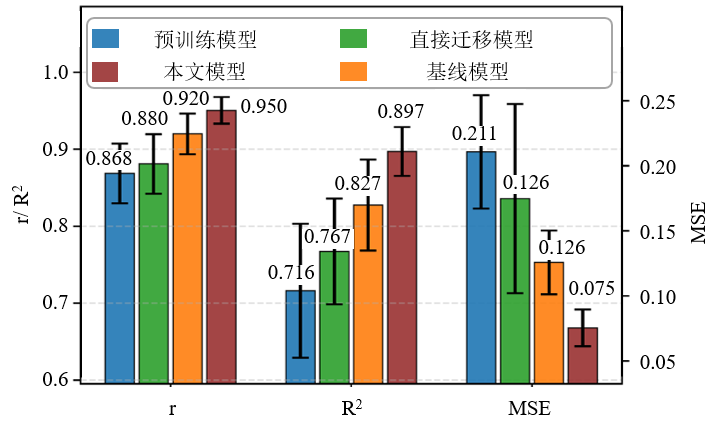
图3本模型与其他模型在 K 折交叉验证下的综合性能对比
3.2更多实测数据能否进一步提升模型性能?
所提出框架具有一定的持续学习能力。随着目标域实测数据不断增加(图4),模型可持续更新并学习新的区域建筑特征和地震响应规律,实现预测精度和泛化能力的不断提升,具有较好的区域适应性和工程可扩展性。
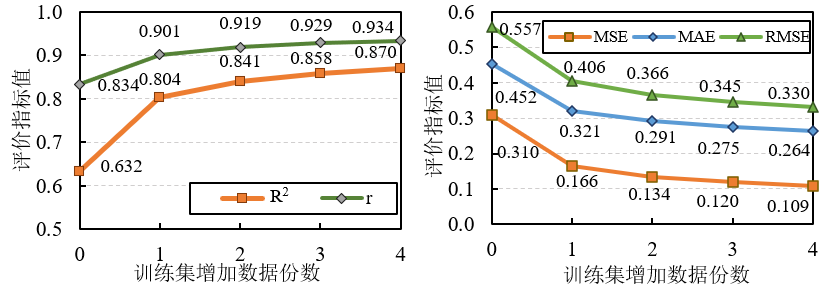
图4目标域训练数据规模对模型预测性能的影响
3.3 换一类建筑,还要重新训练大模型吗?
不需要,蒸馏迁移框架可以快速本地化。
例如,当目标区域中部分建筑(例如 4–6 层建筑)具备可获取的实测地震响应数据时,本文提出的知识蒸馏迁移框架可进一步结合这些数据进行区域本地化定制。结果如图5所示,由图可见,实测数据直接训练模型受样本规模限制,预测离散性较大,R2仅为0.7412;相比之下,本文的知识蒸馏迁移模型将R2提升至 0.9267。该框架还显著提高了模型构建效率:在 AMD Ryzen 7 5800H 3.20 GHz平台上,模型构建仅需约0.2 h,而对照方案约需14.4 h,效率提升约72倍,从而降低了跨建筑类型和区域场景下的模型开发与更新成本。
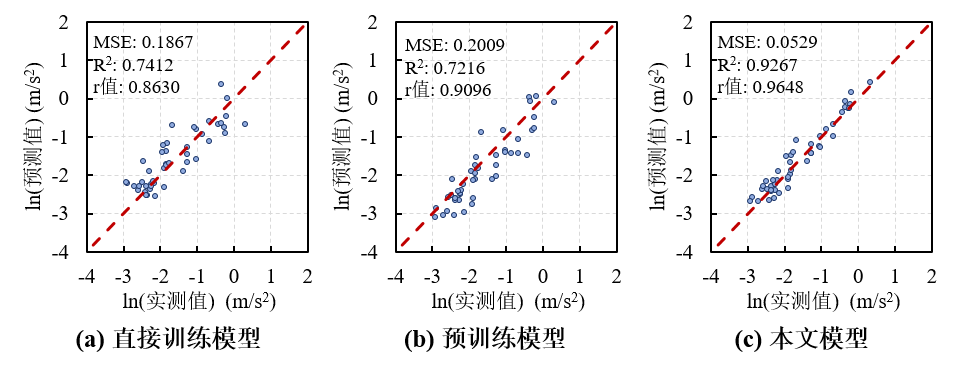
图5 4–6 层建筑地震响应预测的三种训练策略对比结果
4
结论
针对大规模模拟数据与有限实测数据之间存在分布差异、导致城市建筑群地震响应预测泛化能力不足的问题,本文提出了一种融合知识蒸馏与迁移学习的预测框架。该方法以大规模数值模拟数据构建源域,利用少量CESMD实测强震记录进行目标域适配,实现了模拟数据与实测数据的有效融合。主要结论如下:
(1) 小样本实测数据下,预测精度显著提升。通过“教师–学生”知识蒸馏结构与迁移学习相结合,模型在目标域样本有限时仍能保持较高精度。迁移后模型R2达到0.89,相比未迁移模型提升约25.3%,MSE降低约64.5%,整体优于未迁移模型和仅基于实测数据训练的模型。
(2) 可随监测数据积累持续优化。随着目标域实测训练数据增加,模型的R2和相关系数r持续提高,误差指标逐步降低,表明该框架具备一定持续更新与迭代提升能力,适用于长期城市建筑群地震响应评估。
(3) 模型构建效率大幅提升。“先蒸馏、再迁移”的策略能够复用源域预训练知识,并结合区域实测数据快速构建本地化模型。相比传统独立预训练再迁移方案,本文流程将模型构建效率提升约72倍,显著增强了工程应用的可扩展性。
联络邮箱:
---End--
建筑结构生成式智能设计软件:
相关研究
学术报告视频
专著
人工智能与机器学习
---结构智能设计
建筑平面您说咋改就咋改,剩下的都交给AI了|新论文:ChatHouseDiffusion:提示词引导的建筑平面图生成与编辑方法
三大生成式AI + 三大优化算法,谁是BRB加固设计的最优组合?| 新论文:钢筋混凝土框架结构BRB智能加固设计方法对比分析
---其他土木工程领域人工智能研究
城市灾害模拟与韧性城市
高性能结构与防倒塌
新论文:抗震&防连续倒塌:一种新型构造措施
长按识别二维码,关注我们的科研动态